Zenn (AI)Japan
Claude Code で Haiku・Sonnet・Opus とエフォートを変えて22課題を解かせたら、差が出たのは実装より上流だった

Claude Code で、同じ課題をモデル(Haiku 5.5 / Sonnet 5.5 / Opus 5.5)とエフォート(low / medium / high / xhigh / max)を変えて解かせ、精度・時間・費用を測りました。課題は実装・不明点の洗い出し・資料読解・仕様書・試験仕様の22題で、測定は2026年10月です。 結果から決めた使い分けは次のとおりです。
Read at Zenn (AI) ↗Related
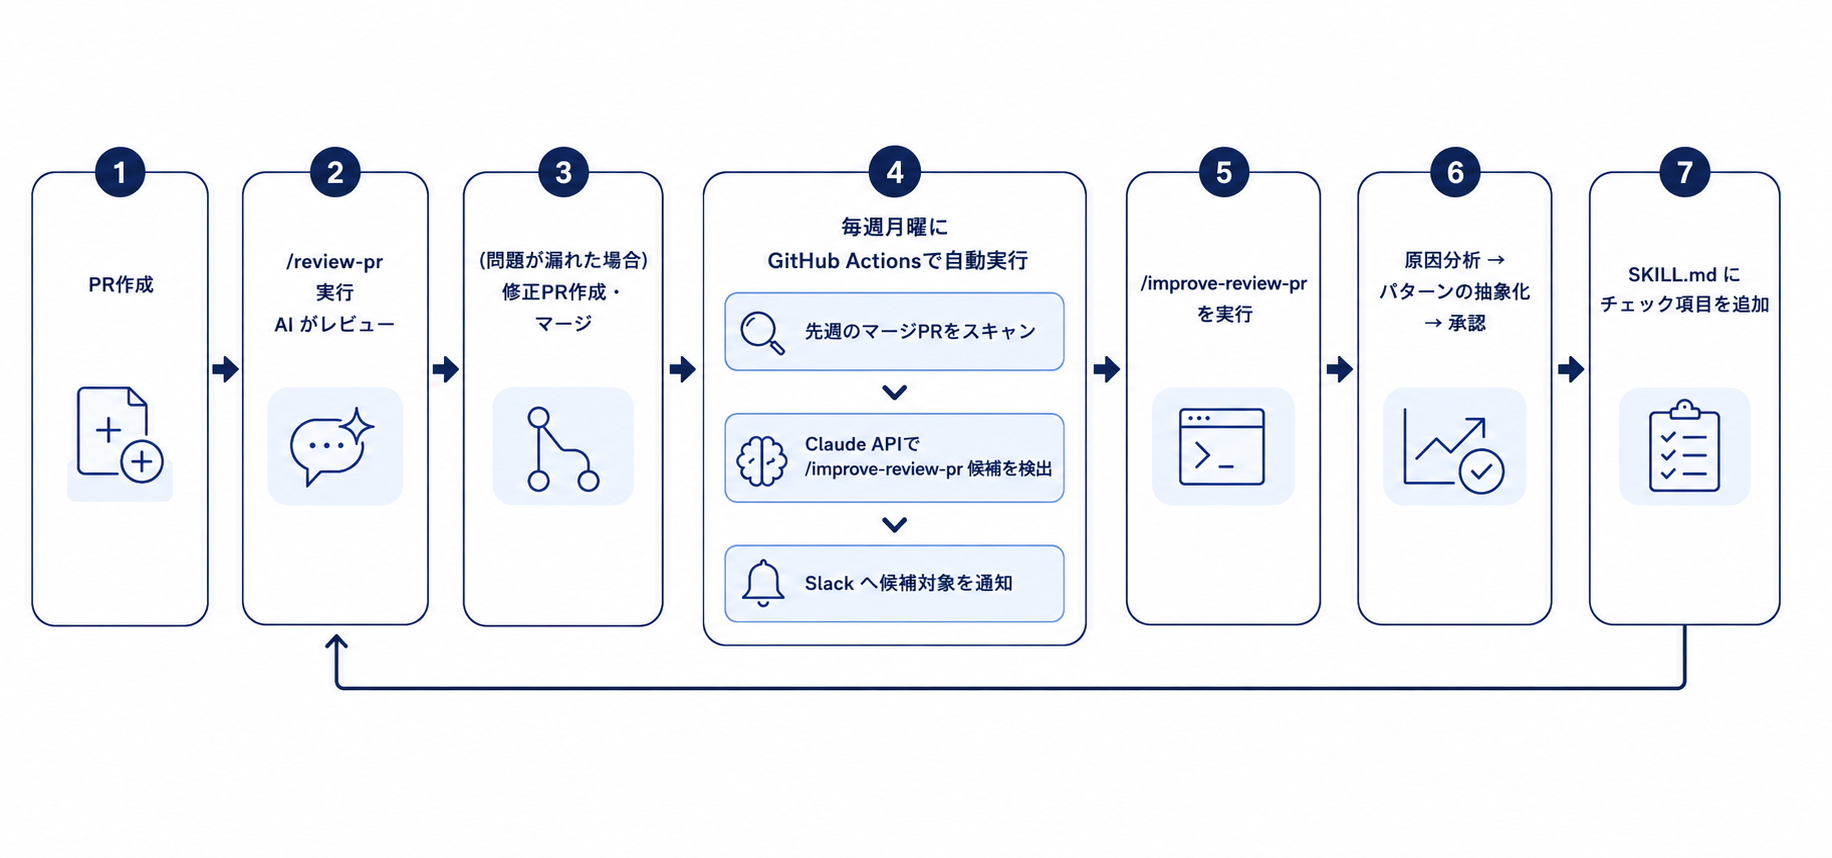
Japan修正PRを食べてレビュースキルが賢くなる:Claude Codeによる自己改善サイクル Mercari Engineering
LabsAgentic engineering intelligence with Amazon Nova Multimodal Embeddings and Amazon Bedrock AgentCore AWS Machine Learning

JapanAIエージェントの購入委任をRubyで扱う — AP2対応SDK v1.0.0を公開しました Zenn (AI)

JapanGeminiのカスタムアシスタント「Gem」から「スキル」への移行入門 Zenn (AI)
SiliconAnthropic confirms new Claude Code limits to prevent game cloning, users report blocking reverse engineering tasks Tom's Hardware
